Redis-kompatibel minneslagring med inbyggd vektorsökning
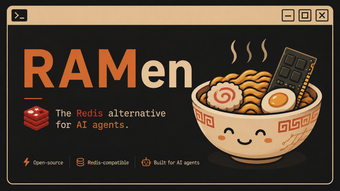
RAMen, av Rohit Dnath, är en minnesbaserad datalagring byggd för att stödja AI-drivna arbetsflöden och agentminne. Verktyget accepterar nyckel-värde-stil åtkomst samtidigt som det lägger till semantisk hämtning så att applikationer kan hämta innehåll efter betydelse istället för exakta träffar. Det riktar sig till AI-utvecklare och backend-ingenjörer som behöver en lokal lagring för att minska latens och undvika upprepade modellanrop, och integreras med agentekosystem som använder ett protokoll för utbyte av modellkontext.
Vilka uppgifter kan du faktiskt använda den för?
Verktyget fungerar som en in-memory lagring som förenar Redis-stil åtkomst med vektor och semantisk hämtning för AI-arbetsbelastningar. Det accepterar Redis-protokollkommandon, exponerar semantisk caching för betydelsebaserade uppslag, och kör en Model Context Protocol-server som agenter kan fråga direkt. Den centrala implementationen är skriven i Go och optimerad för in-memory prestanda, så användningsfall inkluderar snabb lokal hämtning för agentminne, sessionskontext och cachade LLM-svar.
Hur exakt är semantisk hämtning för AI-arbetsflöden?
Semantisk caching lagrar och hämtar AI-svar baserat på betydelse snarare än exakta nyckelordsöverensstämmelser, en design avsedd att minska LLM-anrop och sänka latens under hämtning. Den inbyggda vektorsökningen hanterar högdimensionella inbäddningar för att stödja dessa uppslag. Utdata återspeglar index- och inbäddningskvalitet, så team bör validera cachade svar mot sina applikationsdata innan de förlitar sig på dem för faktiska eller höginsatsbeslut.
Vilka miljöer och klienter stöder den?
Distribueringsmodellen är en enda Go-binär, vilket förenklar distributionen över system som kan köra Go-program. Verktyget implementerar ett drop-in Redis-protokoll så befintliga Redis-klienter och kodbaser kan interagera utan betydande modifiering. För agentarbetsflöden integrerar det med vilken AI-klient eller plattform som stöder Model Context Protocol, med namngivna exempel inklusive Claude Desktop och Cursor, vilket möjliggör direkt dataåtkomst från agenter.
Är det lätt att anta i befintliga stackar?
Antagande centrerar kring utvecklarens ergonomi och öppen källkod beredskap. BSD-3-Clause-licensen och ett GitHub-värd projekt gör kodåteranvändning enkel, och utvecklarens bakgrund inom backend-system, Node.js, TypeScript och Go tyder på en betoning på API- och distributionsdisciplin. Eftersom verktyget riktar sig till ingenjörer och AI-agentbyggare, förvänta dig ett utvecklingsorienterat arbetsflöde som gynnar repository-integration, kodnivåkonfiguration och iterativ testning snarare än grafisk administration.
Vem bör överväga detta verktyg
Verktyget är ett pragmatiskt val för ingenjörsteam som bygger agentstödda tjänster som behöver lokal hämtning och utvecklarkontroll. Dess öppen källkodsorientering stöder repository-drivna integrationer, men team bör validera semantiska cache-utdata mot sina dataset och bekräfta att deras agenter kan få tillgång till lagret via den nödvändiga kontextprotokollet innan de distribuerar i stor skala. Behandla det som en ingenjörskomponent, inte en plug-and-play slutanvändarprodukt.